시뮬레이션에서 장애물을 잘 피하던 로봇이 교실 바닥에서는 계속 뒤로 갔다.
이틀 동안 그 이유를 찾은 기록.
10월 6일 (월)
수업 중에 한 학생이 물었다. "로봇이 스스로 피하는 법은 누가 가르쳐요?"
지금까지는 내가 규칙을 짜서 넣었다. 장애물이 왼쪽에 있으면 오른쪽으로 꺾는 식이다. 그런데 그건 "로봇이 배웠다"고 말하기 어렵다. 그래서 같은 로봇, 같은 카메라로 두 가지를 비교해 보기로 했다. 하나는 내가 짠 규칙, 다른 하나는 강화학습으로 로봇이 스스로 찾은 방법이다.
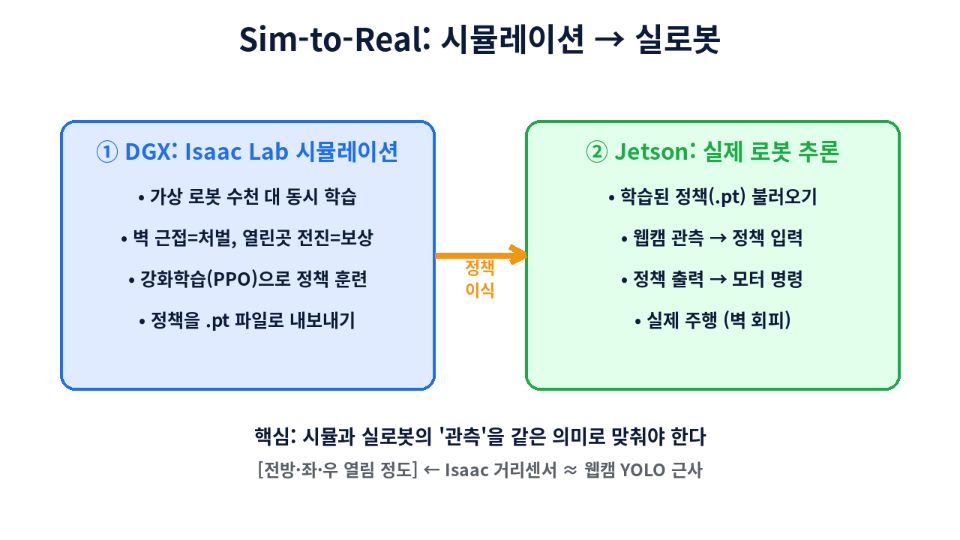
컴퓨터는 두 대로 나눴다.
- 학습: DGX Spark에 Isaac Lab을 깔고 가상 Jetbot 2,048대를 동시에 굴린다.
- 주행: Jetson Orin Nano Super 8GB(JetPack 7.2), L298N 모터 드라이버, 2륜 차동구동, USB 웹캠, YOLO11n.
오린 나노는 CPU와 GPU가 8GB 메모리를 나눠 쓴다. 여기서 학습까지 돌리는 건 무리라서, 학습은 DGX에서 하고 오린 나노는 결과물인 정책 파일(약 118KB)만 받아 쓰기로 했다.
처음 막힌 곳은 모터 전원이었다. 6V 배터리로는 바퀴가 돌다 말다 했다. 전압 강하였다. 12V를 넣고 나서야 제대로 돌았다.
비교 기준부터 만들었다. 학습 없이 바로 돌아가는 규칙 기반 회피다. 화면 아래쪽을 왼쪽·가운데·오른쪽 셋으로 나누고, 가장 덜 막힌 쪽으로 핸들을 꺾는다.
def decide(scores, block_th=0.12, base_speed=0.4):
    left, center, right = scores          # 구역별 막힘 점수(0~1)
    if center < block_th:                 # 앞이 비었으면 전진
        return base_speed, (right - left) * 0.8, "전진"
    if min(left, right) > block_th * 1.5:
        return 0.0, 0.0, "정지(양쪽막힘)"
    return (base_speed * 0.3, 0.9, "좌회전") if left < right else (base_speed * 0.3, -0.9, "우회전")
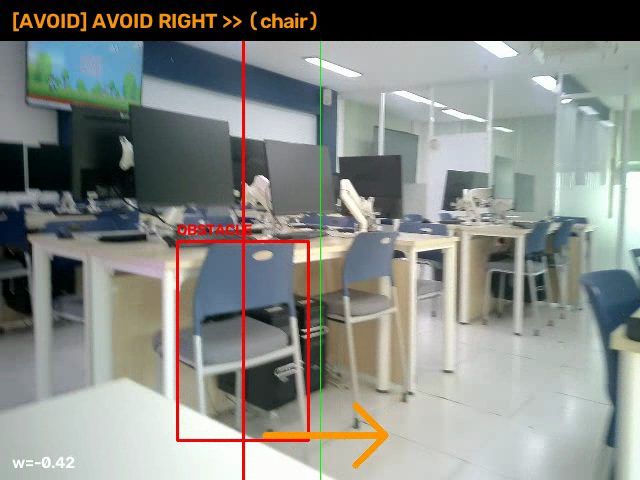
단순하지만 바로, 예측한 대로 움직였다.
내친김에 "YOLO가 보고 작은 LLM이 판단"하는 방식도 재 봤다. 15W 모드에서 10번씩 돌린 최솟값이다.
| 구성 | 지연 | 초당 판단 |
|---|---|---|
| YOLO만 | 약 38ms | 약 26회 |
| YOLO + llama3.2 1B | 131ms | 7.6회 |
| YOLO + llama3.2 3B | 714ms | 1.4회 |
3B는 판단 한 번에 0.7초가 걸린다. 그 사이 로봇은 이미 벽에 닿는다. 핸들은 YOLO에 맡기고, LLM은 "멈출까 말까" 정도의 느린 판단에만 쓰는 게 맞겠다.
밤에는 Isaac Lab 학습을 시작했다. 처음에는 "목표까지 직선거리가 줄어들면 보상"으로 줬다. 그랬더니 로봇이 ㄷ자 통로에서 벽에 딱 붙었다. 벽 너머가 목표 쪽이니 직선거리로는 가까워진 셈이다. 내가 준 보상이 거짓말을 하고 있었다.
10월 7일 (화)
새벽에 보상을 고쳤다. 통로 중심선 위에 로봇 위치를 투영하고, 그 선을 따라 얼마나 왔는지로 계산했다. 이번에는 로봇이 코너를 돌았다.
오전에는 물리 엔진을 Newton(MuJoCo-Warp)으로 바꿔 봤다. 첫 평균 보상이 -10^32 근처로 튀었다. NaN이었다. 바닥 마찰값을 명시하고 nan_to_num으로 막았지만 불안해서, 최종 회피 학습은 PhysX로 되돌렸다.
오후에는 회피 전용으로 다시 짰다.
- 관측 5개: 앞·왼쪽·오른쪽이 얼마나 열려 있는지(레이캐스트 거리 ÷ 2m), 선속도, 각속도
- 행동 2개: 왼쪽·오른쪽 바퀴 속도
- 보상: 열린 쪽으로 가면 +, 경로를 따라 나아가면 +, 목표에 닿으면 +300. 벽에 0.6m보다 가까워지면 거리의 제곱만큼 감점, 0.18m 안이면 크게 감점, 가만히 있어도 감점.
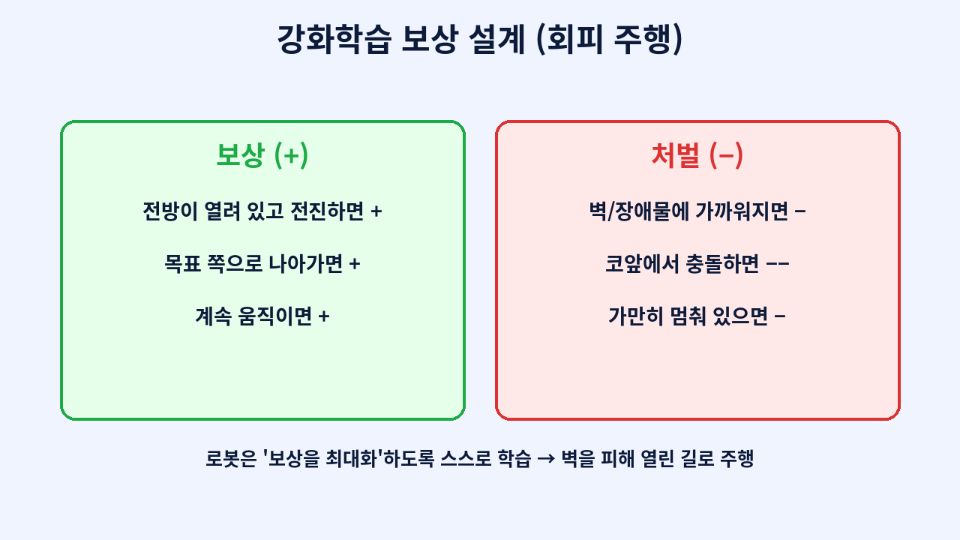
알고리즘은 PPO, 네트워크는 128-128-64였다. 가중치를 바꿔 가며 일곱 번 돌렸다.
| 실행 | 전진 보상 | 벽 감점 | 학습률 | 반복 | 마지막 평균 보상 |
|---|---|---|---|---|---|
| r1 | 8 | 6 | 1e-3 | 300 | 456 |
| r2 | 10 | 8 | 1e-3 | 300 | 532 |
| r3 | 8 | 12 | 1e-3 | 400 | 440 |
| r4 | 12 | 6 | 5e-4 | 400 | 626 |
| r5 | 10 | 10 | 1e-3 | 500 | 681 |
| r6 | 6 | 15 | 1e-3 | 400 | 569 |
| r7 | 14 | 8 | 5e-4 | 500 | 1,118 |
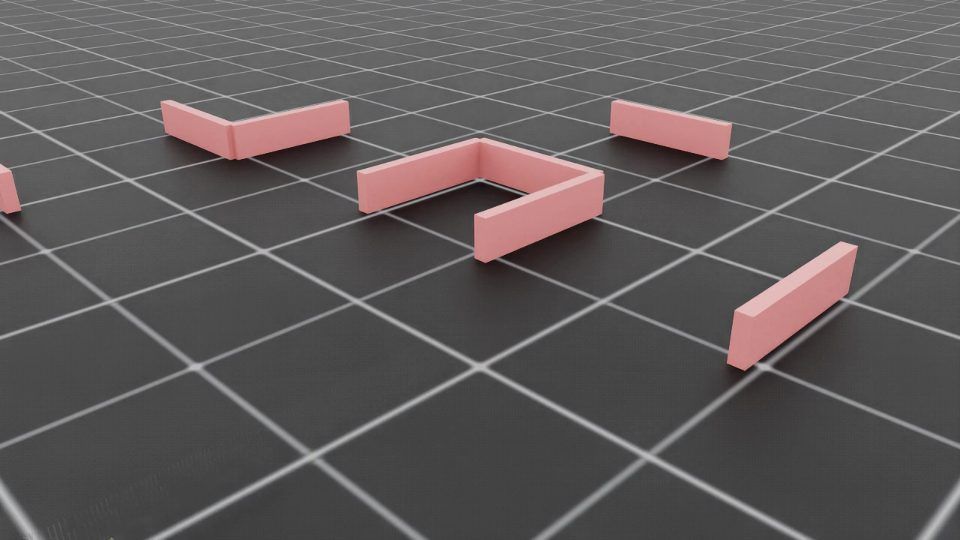
점수가 가장 높은 r7을 골랐다. 시뮬레이션 영상 속 Jetbot은 분홍 벽 사이를 빠져나가 목표까지 갔다. 이때는 다 됐다고 생각했다.
웹캠에는 레이캐스트가 없다. 그래서 YOLO로 흉내를 냈다. 화면을 세 구역으로 나누고, 구역마다 가장 큰 장애물 박스가 화면의 12%를 넘으면 "완전히 막힘"으로 쳤다.
def yolo_to_distsensor(dets, w, h):
    zone_block = [0.0, 0.0, 0.0]                  # 좌, 중, 우
    for (cx, area) in dets:
        zi = 0 if cx / w < 1/3 else (1 if cx / w < 2/3 else 2)
        zone_block[zi] = max(zone_block[zi], min(area / 0.12, 1.0))
    return 1 - zone_block[1], 1 - zone_block[0], 1 - zone_block[2]   # 앞, 왼쪽, 오른쪽
오후 4시 50분쯤 교실에서 돌렸다. 로봇이 뒤로 갔다.
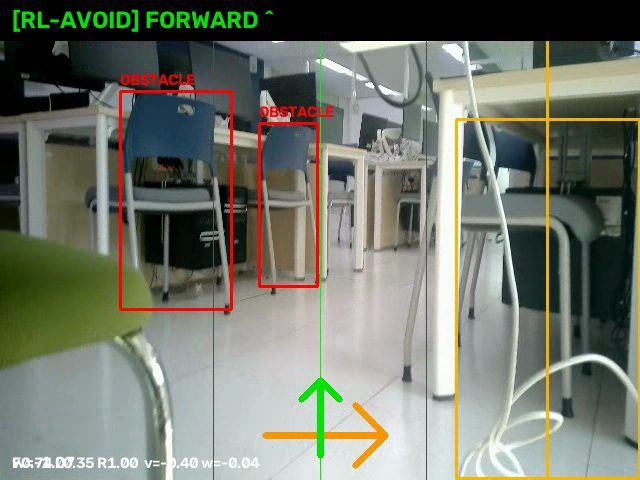
녹화를 다시 보니 이상했다. 의자 두 개를 잡았는데 화면에는 계속 FORWARD가 떴다. 그런데 아래 숫자는 v=-0.40이었다. 전진이라면서 속도는 음수다.
10월 11일 (일)
블로그에 정리하려고 정책 파일을 열었다. 관측값을 손으로 넣고 출력을 하나씩 찍어 봤다.
| 넣은 상황 | 정책 원래 출력 [좌, 우] | 시뮬에서 실제로 쓰인 값 |
|---|---|---|
| 사방이 열림, 멈춤 | [-33.5, -27.4] | [-1, -1] |
| 사방이 열림, 주행 중 | [-16.0, -12.3] | [-1, -1] |
| 앞이 막힘 | [+360.7, +430.6] | [+1, +1] |
| 왼쪽이 막힘 | [-16.0, -50.0] | [-1, -1] |
| 오른쪽이 막힘 | [-20.8, -25.0] | [-1, -1] |
보고 나서야 이해가 됐다. 원인은 세 가지였다.
첫째, 앞뒤가 반대였다. 더 단순한 "목표 방향으로 가기" 정책도 목표가 앞에 있으면 [-1, -1]을 낸다. 보상은 전진해야만 오르는데 학습이 잘 됐다. 그러니 Isaac의 Jetbot은 바퀴에 음수를 줄 때 앞으로 가는 것으로 보인다. 아직 시뮬에서 직접 확인하지는 않았고, 출력 패턴으로 추정한 것이다. 실로봇 코드는 이 값을 그대로 썼다. 그래서 시뮬의 전진이 교실에서는 후진이 됐다. 화면 글자는 회전값만 보고 정하고 있었기 때문에 FORWARD라고 떴다.
둘째, 로봇이 배운 동작은 사실상 두 가지뿐이었다. 출력이 수십에서 수백인데 -1~1로 자르니 "끝까지 전진" 아니면 "끝까지 후진"만 남는다. 옆이 막혀도 돌지 않는다. ㄷ자 미로 하나에서만 연습했으니, "앞이 막히면 물러서고 아니면 직진"만 해도 점수가 충분히 나왔을 것이다. 동작 감점은 자른 뒤 값에 걸려 있었다. 그래서 출력이 커지는 것을 막지 못했다.
셋째, 눈이 달랐다. YOLO는 의자나 사람 같은 물체만 안다. 벽, 케이블, 검은 상자는 못 본다. 그래서 바로 앞이 막혀 있어도 "앞이 완전히 열림(1.00)"이 들어갔다. 선속도 자리에도 실제로 잰 값이 아니라 직전 명령값을 넣고 있었다.
강화학습이 실패한 게 아니었다. 시뮬과 교실 사이의 약속을 내가 안 맞췄다. 부호, 값의 범위, 관측의 뜻이다. 규칙 기반은 그런 약속이 처음부터 없어서 바로 됐다.
r7을 고른 이유도 다시 생각해 봤다. 가중치가 다르면 점수 크기 자체가 달라진다. 1,118점이 456점보다 두 배 잘했다는 뜻이 아니다. 평균 보상으로 실행끼리 순위를 매긴 것부터 잘못이었다.
다음에 할 일
- 시뮬에서 바퀴에 [+1, +1]을 1초 넣어 어느 쪽으로 가는지 기록하고, 실로봇 쪽에서 한 번만 뒤집는다.
- 정책 출력에 tanh를 씌운 채로 학습한다. 아니면 자르기 전 원래 값에 감점을 건다.
- 시뮬에도 카메라를 달아, 실로봇과 똑같은 "구역별 막힘 점수"로 학습한다. 조명과 잡음도 섞는다.
- 장애물 배치를 매번 바꿔서 회전을 배울 수밖에 없게 만든다.
- 평균 보상 대신 목표 도달률, 충돌 횟수, 완주 시간으로 비교한다.
- 바퀴 엔코더가 없으니 선속도 관측은 빼거나, 학습할 때도 명령값을 넣는다.
이 과정은 학생용 자료(10개 모듈, 110차시) 중 7~8모듈에 그대로 넣을 생각이다. 성공한 예제보다 이 실패가 더 좋은 교재다. 학생들에게는 이렇게 물어볼 것이다.
- 시뮬레이션의 "앞"과 로봇의 "앞"이 같다는 건 누가 확인했나?
- 1,118점은 456점보다 두 배 잘한 걸까?
- 카메라가 못 본 것을 정책은 "없는 것"으로 받아들인다. 자율주행 차에서는 이게 어떤 사고로 이어질까?
안전 수칙은 처음부터 끝까지 같다. 모터는 GPIO에 바로 꽂지 않고 드라이버를 거친다. GND는 공통으로 묶는다. 처음에는 바퀴를 공중에 띄우거나 --sim으로, 최고 속도 0.3에서 시작한다.